کنترلپلین و دیتاپلین سیسکو
سه پلین، از CPU سوئیچ دسترسی تا QFP و سوپروایزر
اگر روی 2960 یا 3750 یک بار CPU به سقف رسیده و همزمان درخت STP بههم ریخته، یا روی Catalyst 9300 پینگ به خود سوئیچ میپرد ولی ترافیک کاربران هنوز رد میشود، همان جایی است که باید سه پلین را از هم جدا ببینید. جعبه سیسکو یک مغز و یک جاده است. مغز تصمیم میگیرد. جاده فریم را رد میکند. اگر این دو را یکی حساب کنید، هم عیبیابیتان غلط میشود و هم کانفیگ محافظتیتان یا بیاثر است یا خودِ شبکه را میکُشد.
این مطلب همان کنترلپلین و دیتاپلین سیسکو است، بهعلاوه پلین سومی که اغلب داخل دومی قایم میشود: منیجمنتپلین. از تعریف رسمی NX-OS و Catalyst 9000 شروع میکنیم، یک بسته را سه بار از یک سوئیچ رد میکنیم، CEF و FIB و adjacency را باز میکنیم، بعد تفاوت IOS کلاسیک، IOS XE روی Catalyst 9000 و ASR 1000، NX-OS، IOS XR، ASA و وایرلس را میگوییم. CoPP، سقف حدود ۱۹ هزار بسته در ثانیه روی CPU خانواده Catalyst 9000، و دستورهایی که واقعاً مسیر punt را نشان میدهند وسط همین مسیرند؛ نه ضمیمه آخر.
روی کاغذ هر شاسی «سه صفحه» دارد. در عمل اسمها بین پلتفرمها یکی نیست. مستند عیبیابی Catalyst 9000 کلمه Control Plane را برای هر چیزی که به CPU میرسد به کار میبرد، از BPDU تا SSH. راهنمای CoPP نکسوس همان ترافیک را به control و management شکافته است. اگر این اختلاف را ندانید، یک policy را از روی یک PDF به پلتفرم دیگر کپی میکنید و فردا OSPF فلپ میشود.
سه پلین دقیقاً چه هستند
راهنمای امنیت NX-OS، از جمله نسخه 10.6، سه جزء را اینطور از هم جدا میکند. این تعریف را معیار میگیریم، چون از بقیه صریحتر است:
- Data plane همه ترافیک داده را جابهجا میکند. کار پایه دستگاه این است که بسته را از یک اینترفیس به اینترفیس دیگر بفرستد. بستهای که مال خود سوئیچ نیست transit نام دارد و دیتاپلین آن را برمیدارد.
- Control plane ترافیک پروتکل مسیریابی را هندل میکند. BGP و OSPF بسته کنترلی بین دستگاهها میفرستند. این بستهها به آدرس خود روتر میرسند.
- Management plane اجزای مدیریت دستگاه را اجرا میکند؛ CLI و SNMP در خود مستند سیسکو مثال زده شدهاند.
دیتاپلین همان forwarding plane است. کنترلپلین تصمیم میسازد و آن تصمیم را به جدول فوروارد میریزد. منیجمنتپلین دستگاه را اداره میکند: شما SSH میزنید، سرور مانیتورینگ SNMP میخواند، یا اسکریپت NETCONF کانفیگ را هل میدهد. هیچکدام از این سه، «جایگزین» دیگری نیست. اگر دیتاپلین سالم باشد و کنترلپلین مرده باشد، ترافیک موجود تا زمان انقضای adjacency و تایمر پروتکل رد میشود و بعد سیاهچاله میشود. اگر کنترلپلین زنده باشد و دیتاپلین اشباع شده باشد، همسایه OSPF up است ولی کاربر صف را حس میکند.
مرز خاکستری است و سیسکو هم این را پنهان نمیکند. یک فریم تا وقتی مقصدش میزبان آنطرف سوئیچ است دیتاپلین است. همان فریم اگر آدرس مقصدش SVI خود سوئیچ باشد، برای دستگاه است و باید به CPU برود. بسته OSPF hello بین دو روتر، از دید کابل «دیتا» است (یک IP روی سیم)، از دید روتر «کنترل» است. SSH هم روی سیم یک TCP معمولی است و از دید NX-OS مال منیجمنتپلین است، ولی روی Catalyst 9000 داخل همان لولهای میافتد که سیسکو به آن punt به control plane میگوید.
| بسته | مال کیست | کجا تمام میشود |
|---|---|---|
| فریم کاربر از پورت access به uplink | transit | دیتاپلین، ASIC یا QFP، بدون CPU |
| OSPF hello، BGP update، BPDU، LACP، CDP | پروتکل بین دستگاهها | کنترلپلین، CPU |
| SSH، SNMP، NETCONF، HTTPS مدیریتی | اپراتور یا NMS | منیجمنتپلین؛ باز هم CPU، گاهی از پورت جدا |
| پینگ به آدرس خود روتر | for-us | CPU؛ روی 9000 صف forus |
| پینگ از پشت روتر به مقصدی در اینترنت | transit | دیتاپلین؛ CPU دخالت نمیکند مگر استثنا |
| ARP برای میزبان همان subnet | ناقص بودن adjacency | یک بار punt (glean)، بعد دوباره سختافزار |
یک بسته، سه سرنوشت
یک Catalyst را تصور کنید با SVI به آدرس 10.10.10.1، یک PC روی 10.10.10.10، و uplink به سمت روتر شعبه. سه آزمایش کافی است تا هر سه پلین را با دست خودتان ببینید.
- PC به سرور آنطرف uplink. سوئیچ MAC یا مسیر را در سختافزار پیدا میکند و فریم را از پورت خروجی میفرستد.
show processes cpuتکان نمیخورد. این دیتاپلین است. - PC به
10.10.10.1پینگ میکند. مقصد خود دستگاه است. بسته punt میشود. اگر هزار نفر همزمان به SVI پینگ کنند، CPU بالا میرود در حالی که عبور کاربران هنوز ممکن است سالم باشد. این for-us است؛ نه transit. - شما به
10.10.10.1روی SSH میروید. باز هم به CPU میرسد، ولی کارش اداره دستگاه است نه ساخت جدول مسیریابی. اگر این جلسه را روی همان VLAN کاربران آورده باشید، طوفانی که آزمایش دوم راه انداخت SSH را هم از شما میگیرد.
دیتاپلین: از process switching تا CEF
هر بسته transit یک سؤال دارد: از کدام اینترفیس بیرون برود و هدر لایه دو خروجیاش چه باشد. سیسکو این سؤال را در طول سالها سه جور جواب داده. اسم هر سه را هنوز در خروجی دستورها میبینید، حتی اگر روی IOS XE امروز فقط سومی زنده باشد.
Process switching
هر بسته را خود پروسه IP روی CPU برمیدارد، در RIB دنبال longest-match میگردد، و میفرستد. این کندترین حالت است و برای نرخ بالا ساخته نشده. اگر کسی روی روتر قدیمی no ip cef گذاشته باشد، یا ویژگیای روشن باشد که بسته را از مسیر سختافزار بیرون بکشد (مثل log روی هر hit یک ACL شلوغ)، عملاً به همین دنیا برمیگردید. علامت میدانیاش ساده است: با چند جریان همزمان، CPU فرآیند IP Input بالا میرود و تأخیر کاربران با بار خود روتر بالا و پایین میشود.
Fast switching
نسل وسط. بسته اول process میشد و نتیجه در route cache مینشست؛ بستههای بعدی همان مقصد در سطح interrupt فوروارد میشدند. مشکلش demand cache بود: میلیون مقصد مختلف یعنی cache که هیچوقت گرم نمیماند. CEF آمد که این را حل کند. روی پلتفرمهای IOS XE امروزی این حالت مدل عملیاتی شما نیست؛ اگر در متن قدیمی آموزشی میبینیدش، تاریخ است نه دستور امروز.
CEF
Cisco Express Forwarding جدول فوروارد را از قبل میسازد، نه بعد از دیدن بسته اول. دو ساختار دارد. FIB نسخه بهینه RIB برای جستوجوی پیشوند است. Adjacency table میگوید برای رسیدن به hop بعدی، هدر لایه دو چیست: MAC مقصد، اینترفیس خروجی، و اگر لازم باشد VLAN tag. پروتکل مسیریابی RIB را عوض میکند؛ CEF از RIB مشتق میشود و روی سختافزار، همان FIB به ASIC یا QFP برنامه میشود. به همین دلیل همسایه OSPF که فلپ میکند، برای چند لحظه هم کنترلپلین را مشغول میکند و هم برنامهریزی مجدد دیتاپلین را.
مستند «Understand Express Forwarding» سیسکو همین را خلاصه میکند: CEF جایگزین مدل route-cache است، FIB و adjacency را جدا نگه میدارد، و روی پلتفرم مدرن این جدولها با سختافزار فوروارد همگام میشوند. CEF بهصورت پیشفرض روشن است. خاموش کردنش راهحل عیبیابی نیست؛ راه ساختن قطعی است.
| نوع adjacency | معنی | بسته کجا میرود |
|---|---|---|
| عادی (با MAC) | همسایه لایه دو شناخته شده | بازنویسی هدر و خروج از دیتاپلین |
| glean | پیشوند مستقیم را میدانیم، آدرس لایه دو میزبان را نه | punt برای ARP یا Neighbor Discovery؛ بعد از جواب، adjacency کامل میشود |
| punt | این بسته را باید CPU ببیند | کنترلپلین یا منیجمنت |
| drop / null | عمداً دور ریخته شود، مثل Null0 | دورریز در دیتاپلین، بدون اذیت کردن CPU |
دستورهایی که این جدول را روی IOS و IOS XE نشان میدهند:
show ip cef 10.10.20.10
show adjacency
show ip interface GigabitEthernet0/0/1 | include CEF
اگر کنار یک پیشوند glean ماندگار ببینید، یا میزبان جواب ARP نمیدهد یا چیزی در مسیر ARP را میخورد. اگر همه چیز punt شده، CEF برای آن ترافیک کنار رفته و CPU دارد کار ASIC را میکند. این را با «شبکه کند است» یکی نکنید؛ اول بگویید کندی مال عبور است یا مال خود جعبه.
کنترلپلین: پروتکلی که اگر دیر شود شبکه را میخواباند
کنترلپلین بسته transit را فوروارد نمیکند. توپولوژی را نگه میدارد. OSPF hello اگر سه بار پشت سر هم نرسد، adjacency میخوابد و FIB خالی از مسیرهایی میشود که از آن همسایه آمده بودند. BPDU اگر روی 2960 دیر به CPU برسد، پورت میتواند از blocking دربیاید و حلقه بسازد. LACP اگر timeout شود، EtherChannel نصف میشود. اینها همه «چند بسته در ثانیه»اند، ولی مهلتشان کوتاه است.
لایه دو را دستکم نگیرید. روی سوئیچ دسترسی، سنگینترین کنترلپلین اغلب اصلاً BGP نیست. STP، CDP، LLDP، LACP، UDLD، VTP و DTP روی Catalyst 9000 همگی در صف WK_CPU_Q_L2_CONTROL مینشینند. یک حلقه لایه دو، یا یک IP phone که CDP را سیل میکند، همان صفی را پر میکند که BPDU لازم دارد. روتر شعبه داستان دیگری دارد: آنجا OSPF و BGP و HSRP صف routing را پر میکنند.
مستند عیبیابی کنترلپلین Catalyst 9000 چند علت punt را با شماره نشان میدهد. اینها را حفظ کنید، چون خروجی show platform software fed switch active punt cause summary همین اسمها را میدهد:
| علت در خروجی FED | چه بستهای است |
|---|---|
| ARP request or response | حل آدرس لایه دو؛ glean این را راه میاندازد |
| For-us data | بستهای که مقصدش یکی از آدرسهای خود سوئیچ است |
| For-us control | پروتکل کنترلی که باید روی دستگاه تمام شود |
| Glean adjacency | مقصد در subnet متصل است ولی adjacency هنوز ناقص است |
| Layer2 control protocols | STP، CDP، LACP و بقیه صف L2 |
| IP subnet or broadcast | برادکست subnet؛ در VLAN شلوغ تمامنشدنی است |
| Layer2 bridge domain data | دیتایی که استثنائاً از بریج به CPU آمده |
دو کلمه را سیسکو در همان سند تعریف کرده و ارزش دارد عین معنایشان بماند. Punt یعنی بسته کنترلی که دیتاپلین گرفته و به CPU فرستاده. Inject یعنی بستهای که CPU ساخته (hello، پاسخ SNMP، پاسخ ping) و به دیتاپلین داده تا از اینترفیس خارج شود. مسیر برگشت را فراموش نکنید. اگر inject عقب بیفتد، شما hello میفرستید دیر، حتی اگر همسایه سالم باشد.
منیجمنتپلین: همان CPU، ولی قرار نیست از VLAN کاربران بیاید
راهنمای IOS XR منیجمنتپلین را مسیر منطقی ترافیکی میداند که به اداره خود پلتفرم مربوط است، و پروتکلهایش را اسم میبرد: SNMP، Telnet، HTTP، HTTPS و SSH. NX-OS هم CLI و SNMP را در همین پلین گذاشته. یعنی از نظر معماری، SSH «یک جور OSPF» نیست. از نظر سختافزار ارزانتر، هر دو اغلب از یک CPU سردرمیآورند. این اختلاف را در طراحی آدرس مدیریت حل میکنید، نه در اسمگذاری اسلاید.
دو جور اینترفیس مدیریت داریم و XR برای هر دو اسم رسمی دارد:
- Out-of-band. اینترفیسی که برای ترافیک مدیریت کنار گذاشته شده. روی نکسوس معمولاً
mgmt0است، روی ASR 1000 پورت مدیریت RP، روی خیلی از Catalystها پورت GigabitEthernet0/0 که وارد VLAN کاربران نمیشود. طوفان دیتاپلین به این سیم راه ندارد، به شرطی که واقعاً به یک سوئیچ مدیریت جدا رفته باشد نه به همان access. - In-band. همان SVI یا اینترفیس مسیریابی که هم دیتا را عبور میدهد هم SSH را تمام میکند. XR به آن shared management interface میگوید. راحت است و تا روز حادثه هم کار میکند. روز حادثه دقیقاً وقتی به SSH نیاز دارید، in-band همان لولهای است که پر شده.
پروتکلهای جدیدتر هم همین پلیناند، حتی اگر در PDF سال ۲۰۱۰ نباشند: NETCONF، RESTCONF، gNMI و telemetry مدلمحور. همه به CPU یا به یک پروسه مدیریتی روی لینوکس IOS XE میرسند. تفاوتشان با SNMP این است که حجم پاسخ و فرکانسشان میتواند بیشتر باشد. یک subscription درشت telemetry روی جعبه کوچک شعبه همان اثری را دارد که polling یکثانیهای SNMP روی 3750 داشت.
روی IOS XR ویژگی Management Plane Protection از نسخه 3.7.2 هست و پیشفرض خاموش است. تا وقتی روشن نشده، پروتکل مدیریتی که فعال باشد از همه اینترفیسها قابلدسترسی است. با اولین اینترفیس in-band یا out-of-band که زیر MPP میگذارید، ویژگی روشن میشود و اینترفیسهای دیگر آن ترافیک را دور میریزند. پروتکلهایی که MPP محدود میکند، طبق راهنمای ASR 9000: SSH، SNMP (همه نسخهها)، Telnet، TFTP، HTTP و HTTPS. MPP خودش سرویس را روشن نمیکند؛ فقط مشخص میکند سرویسِ روشنشده از کدام در وارد شود. جلسه SSH که قبل از تغییر کانفیگ باز بوده هم قطع نمیشود. و شمارنده بستههای دورریخته را نگه نمیدارد؛ اگر بعد از MPP دیگر به روتر نمیرسید، دنبال drop counter داخل خود MPP نگردید.
لوله باریک بین دیتاپلین و CPU
عدد مهم این معماری را مستند عیبیابی Catalyst 9000 رکورد کرده: خانواده Catalyst 9000 در مجموع حدود ۱۹٬۰۰۰ بسته در ثانیه را به CPU میرساند. بالاتر از این سقف، ترافیک punt بدون وزندهی policed میشود. مقایسه کنید با دیتاپلین همان کلاس سوئیچ که صدها گیگابیت را در ASIC رد میکند. نسبت، تعارف نیست. CPU برای پروتکل ساخته شده، نه برای اینکه جای ASIC را بگیرد.
پس «CPU چهل درصد است» بهتنهایی جمله مفیدی نیست. باید بپرسید کدام CPU. روی IOS XE دو عدد دارید:
show processes cpu sortedبار دیمون IOS است؛ همان IOSd که روی لینوکس IOS XE نشسته و پروتکل و CLI را اجرا میکند.show platform software status control-processor briefبار خود پردازنده کنترل (لینوکس میزبان) را نشان میدهد. ممکن است IOSd خلوت باشد و پروسه دیگری روی لینوکس صندوق را پر کرده باشد.- روی ASR 1000 و ISR 4000،
show platform hardware qfp active datapath utilization summaryبار دیتاپلین QFP است. این یکی اگر بالا باشد، کاربران کندی عبور را حس میکنند حتی اگر CLI هنوز روان باشد.
روی سوئیچ قدیمیتر مثل 2960، این تفکیک را به این تمیزی ندارید. یک CPU هم فریم استثنا را میبیند هم SNMP را. آنجا بالا رفتن CPU تقریباً همیشه یعنی کنترل و مدیریت با هم در خطرند، و علامت کلاسیکش این است که کنسول تکهتکه جواب میدهد و پینگ به خود سوئیچ loss دارد، در حالی که کاربران آنطرف هنوز رد میشوند؛ تا لحظهای که BPDU هم drop شود. از آن لحظه به بعد دیتاپلین هم دیگر قابلاعتماد نیست، چون توپولوژی لایه دو خراب شده.
CoPP همان نگهبان دم در CPU است
Control Plane Policing یک policy از جنس QoS است که روی مسیر punt/inject مینشیند، نه روی پورت کاربر. راهنمای IOS XE این مسیر را punt/inject interface مینامد: از دیتاپلین به RP در جهت ورودی، و از RP به دیتاپلین در جهت خروجی. قانون QoS بعد از آن اعمال میشود که مشخص شده مقصد بسته خود کنترلپلین است. مثال خود سیسکو: محدود کردن TCP SYN به سمت کنترلپلین، مثلاً به یک مگابیت بر ثانیه، قبل از اینکه CPU درگیر handshake شود.
نسخه قدیمیتر IOS (مستند 15M&T) این ایده را به Control Plane Protection گسترش داده و زیر اینترفیس aggregate سه زیرصف ساخته:
- Host: ترافیکی که مقصدش یکی از آدرسهای خود روتر است. SSH، SNMP، BGP، OSPF، EIGRP. بیشتر حفاظت اینجاست.
- Transit: بستهای که مال روتر نیست ولی نرمافزاری سوئیچ میشود؛ مثل بعضی تونلهایی که روی CPU تمام میشوند.
- CEF-exception: چیزی که FIB به فرآیند برگردانده، یا درایور اینترفیس مستقیم در صف ورودی کنترلپلین گذاشته. ARP، keepalive لایه دو، و ترافیک غیر IP میزبان اینجاست. پس ARP را در کلاس host IP جستوجو نکنید؛ سیسکو صریحاً گفته ARP و CDP آنجا نیستند.
CoPP عصای جادویی نیست. اگر نرخ کلاس routing را زیادی پایین بیاورید، خود OSPF را drop میکنید و فکر میکنید «حمله دفع شد». اگر نرخ را بردارید، سیل تا CPU میرود. مستند Catalyst 9300 (IOS XE 16.6) هشدار میدهد که policer کلاس سیستمی را خاموش نکنید؛ حتی اگر خاموش کنید، بعد از بوت بعدی سیستم برای سالم بالا آمدن دوباره نرخ پیشفرض را برمیگرداند. تغییر نرخ نسبت به پیشفرض، طبق سند جدیدتر همان خانواده، حساسیت به اثر جانبی را بالا میبرد. اول drop counter را بخوانید، بعد نرخ را دست بزنید.
همان سه پلین، شاسیهای مختلف
معماری منطقی یکی است. جایی که بسته transit واقعاً لمس میشود فرق میکند. این جدول را موقع خرید یا موقع خواندن show processes cpu کنار دستتان بگذارید.
| پلتفرم | دیتاپلین کجاست | کنترل و مدیریت کجاست | حفاظت دم CPU |
|---|---|---|---|
| Catalyst 2960 / 3750 و همنسلها | ASIC سوئیچ؛ فریم transit به CPU نمیآید | یک CPU برای BPDU، ARP، SNMP، SSH | نرخمحدودکنندههای سادهتر؛ CoPP مدرن را انتظار نداشته باشید. حلقه لایه دو اینجا کشنده است |
| ISR نسل قدیمی (1800/2800/2900) | CEF روی همان CPU، بیشتر در interrupt نه در یک ASIC جدا | همان CPU | CoPP کلاسیک با control-plane و policy-map اگر نسخه IOS داشته باشد. pps واقعی پایین است |
| ISR 4000 و Catalyst 8000 | QFP؛ مسیر داده از مسیر IOS جداست | CPU کنترل، IOSd روی لینوکس | CoPP بهعلاوه آمار جدا برای QFP |
| Catalyst 9000 (IOS XE) | ASIC (خانواده UADP؛ نسل دقیق مال PID است) | CPU، IOSd، FED برای برنامهریزی سختافزار | system-cpp-policy، ۳۲ policer سختافزاری، سقف حدود ۱۹ هزار pps به CPU |
| ASR 1000 | ESP و QuantumFlow Processor؛ فوروارد متمرکز از ESP فعال | RP: IOS، پروتکل، CLI، پورت مدیریت | کانال EOBC بین قطعات کنترل؛ punt به RP فقط برای چیزی که ESP خودش تمام نمیکند |
| Nexus 9000 / 7000 (NX-OS) | فورواردینگانجین لاینکارت یا ASIC خود سوئیچ ثابت | سوپروایزر | CoPP با پروفایل strict بهصورت پیشفرض؛ moderate و lenient و dense |
| ASR 9000 / 8000 (IOS XR) | FIB روی لاینکارت؛ فوروارد توزیعشده | Route Processor، پروسههای جدا با حافظه جدا | LPTS برای بسته به سمت روتر، MPP برای در مدیریت |
| ASA / FTD | through-the-box در مسیر داده فایروال | to-the-box: مدیریت، routing، failover | ACL با کلمه control-plane روی ترافیک به خود جعبه |
اگر قبلاً آشنایی با سیسکو NX-OS را خواندهاید، سوپروایزر در برابر لاینکارت همان شکاف کنترل و داده است. سیسکو SDN این شکاف را از داخل یک جعبه به بیرون میبرد: کنترلر تصمیم میگیرد، تجهیزات فوروارد میکنند. در پردیس، مطلب سیسکو LISP چیست کنترلپلین فابریک است و آشنایی با سیسکو VXLAN دیتاپلین همان فابریک. آن دو مقاله را با این یکی قاطی نکنید: آنجا «پلین» مال overlay است، اینجا مال خود جعبه.
Catalyst 9000: FED، IOSd و سیودو صف
سند عیبیابی سیسکو برای این خانواده چهار اسم را تعریف میکند که بدون آنها خروجی دستورها معماست.
- FED (Forwarding Engine Driver) قلب سوئیچ است و سختافزار را برنامه میریزد. بسته transit را FED و ASIC تمام میکنند.
- IOSd دیمون IOS روی هسته لینوکس است. پروتکل و بخش زیادی از CLI اینجاست.
- PDS (Packet Delivery System) مکانیزم رساندن بسته بین زیرسیستمهاست؛ از جمله از FED به IOSd و برعکس.
- LSMPI اینترفیس حافظه مشترک لینوکس برای مسیر punt است.
CoPP روی 9000 سیودو policer سختافزاری برای سیودو صف دارد. صفها سیستمیاند و شما صف تازه نمیسازید. نرخ policer قابلتغییر است، ولی تنها policy که اجازه دارد روی control-plane بنشیند همان system-cpp-policy است. در راهنمای 16.6 حتی گفته شده هفده کلاس سیستمی را نمیشود پاک کرد، و نرخ کلاس سیستمی فقط بر حسب pps است نه بیت بر ثانیه. show running-config کلاسهایی را که روی مقدار پیشفرض ماندهاند نشان نمیدهد. برای دیدن واقعیت:
show policy-map control-plane
show policy-map system-cpp-policy
show platform hardware fed switch active qos queue stats internal cpu policer
show platform software fed switch active punt cause summary
show platform software fed switch active punt cpuq all
نقشه کلاس به صف، از همان سند (نام کلاس را بدون فاصله تایپ کنید؛ در PDF رسمی بعضی نامها وسط خط شکستهاند):
| کلاس | چه چیزی را نگه میدارد |
|---|---|
system-cpp-police-l2-control |
STP، CDP، LLDP، LACP، UDLD، DTP، VTP، PAgP |
system-cpp-police-routing-control |
OSPF، BGP، EIGRP، RIP، IS-IS، HSRP، VRRP، PIM، LDP، GLBP |
system-cpp-police-forus |
پینگ به خود سوئیچ، Telnet، SNMP، keepalive، بخشی از IKE |
system-cpp-police-data |
ICMP unreachable، TTL expired، redirect، broadcast |
system-cpp-police-dot1x-auth |
802.1X |
system-cpp-police-sw-forward |
فوروارد نرمافزاری و logging |
system-cpp-default |
از جمله DHCP snooping و کنترل eWLC |
system-cpp-police-stackwise-virt-control |
کنترل StackWise Virtual |
صف ۹ و ۱۰ مال وایرلس توکار است: CAPWAP کنترل روی UDP 5246 و CAPWAP داده روی UDP 5247. اگر eWLC روشن باشد و APها بیقرار، این دو صف را ببینید قبل از اینکه سراغ OSPF بروید. در یک خروجی نمونه خود سیسکو روی Catalyst 9600، کلاس system-cpp-police-ios-routing با نرخ ۱۷۰۰۰ pps نشان داده شده. این عدد را به 9300 تعمیم ندهید. سند میگوید مقدار دقیق بین اعضا و نسلهای خانواده فرق میکند. منبع حقیقت، خروجی همان سوئیچ است.
دو سناریویی که سیسکو از فیلد آورده و ما هم زیاد میبینیم: پینگ به IP محلی که گاهوبیگاه drop میشود، و ICMP redirect زیاد که DHCP را هم کند میکند. redirect یعنی روتر یا SVI دارد به میزبان میگوید «از در دیگری برو». اگر این پیامها سیل شود، صف ICMP پر میشود و کشف آدرس و DHCP که همسایه همان CPU هستند عقب میافتند. درمانش معمولاً بستن redirect روی SVI است (no ip redirects)، نه بالا بردن کورکورانه policer.
ASR 1000: سه برد، دو کانال
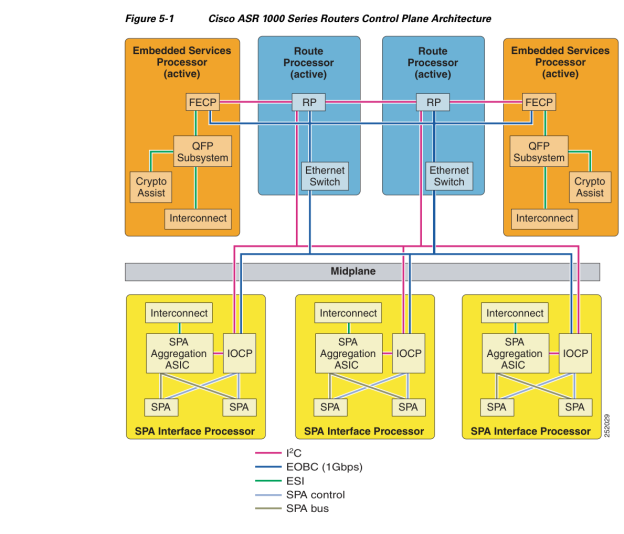
راهنمای عملیات ASR 1000 کنترلپلین را اینطور چیده. سه قطعه اصلی:
- RP پردازنده همهمنظوره است. پروتکل مسیریابی، CLI، اینترفیس مدیریت، نگهداری کد، لاگ، و مدیریت شاسی. بستههای کنترلی شبکه و پروتکلهایی را هم که ESP پشتیبانی نمیکند همینجا پردازش میشوند.
- ESP پردازنده فوروارد است. فایروال، ACL، رمزنگاری و QoS مسیر داده اینجاست. داخل ESP، QFP (QuantumFlow Processor) بستهها را پردازش میکند. همه ترافیک عادی از ESP فعال رد میشود. اگر ESP مشکل پیدا کند، فوروارد میایستد؛ حتی اگر RP هنوز به کنسول جواب بدهد.
- SIP برد اینترفیس است و SPAها را به RP و ESP وصل میکند.
کنترل توزیع شده است، به این معنا که RP و FECP (پردازنده کنترل موتور فوروارد) و IOCP (پردازنده کنترل ورودی/خروجی) هر کدام پردازنده خودشان را دارند. RP این مجموعه را با یک گیگابیت اترنت خارج از باند داخلی به نام EOBC هماهنگ میکند. سلامت قطعات روی I2C دیده میشود. مسیر داده روی midplane لینکهای سریال ESI است که RP و SIP و ESP آماده را به ESP فعال وصل میکند. پس روی این شاسی «کنترلپلین» فقط یک پروسه IOS نیست؛ یک شبکه کوچک داخل جعبه است. اگر EOBC ناسالم باشد، قطعه از نظر RP گم میشود در حالی که کابل مشتری سالم است.
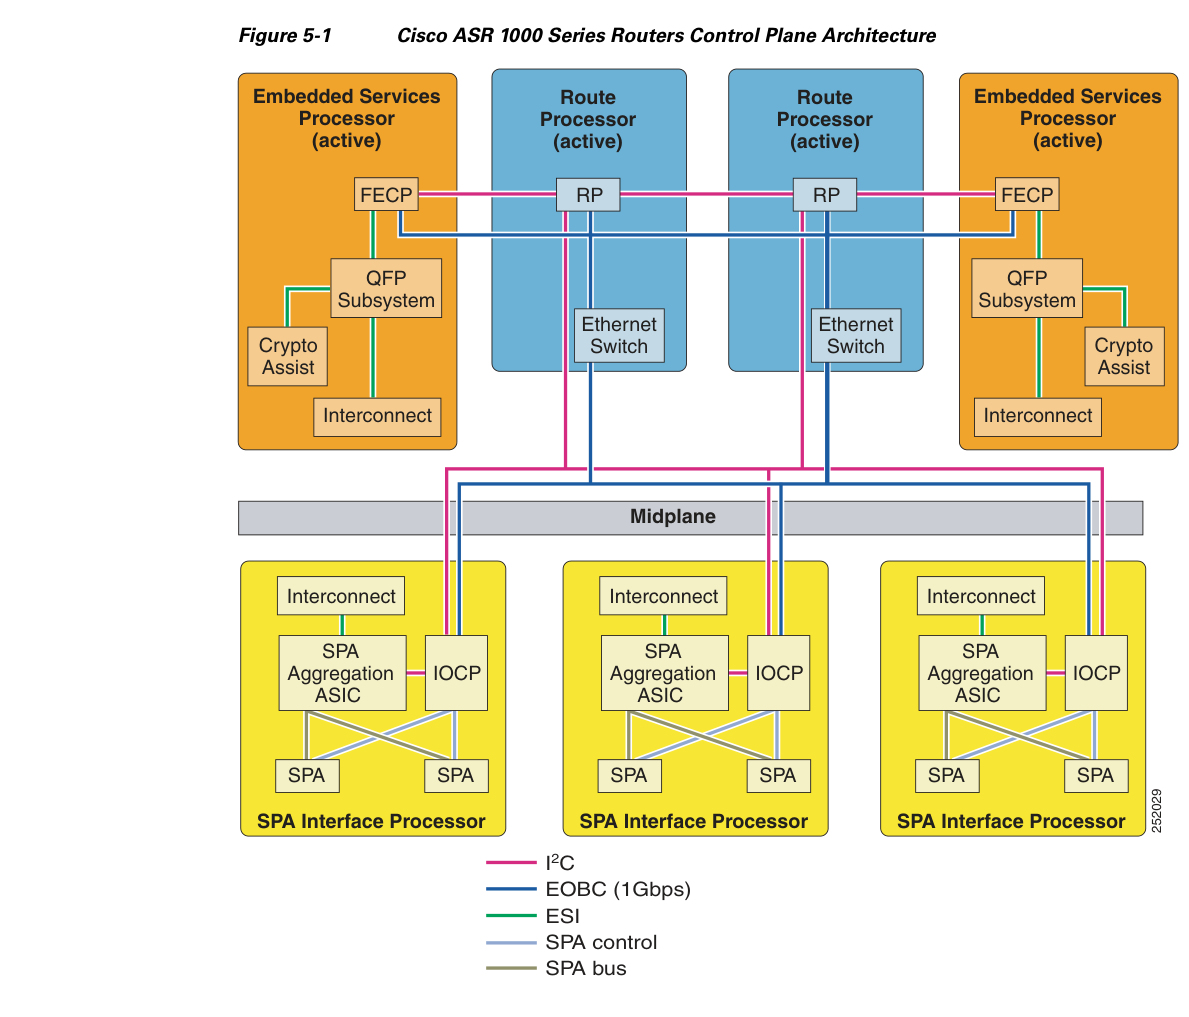
راهنمای عملیات ASR 1000، Figure 5-1: RP، ESP، QFP، SIP و لینکهای EOBC و ESI روی midplane
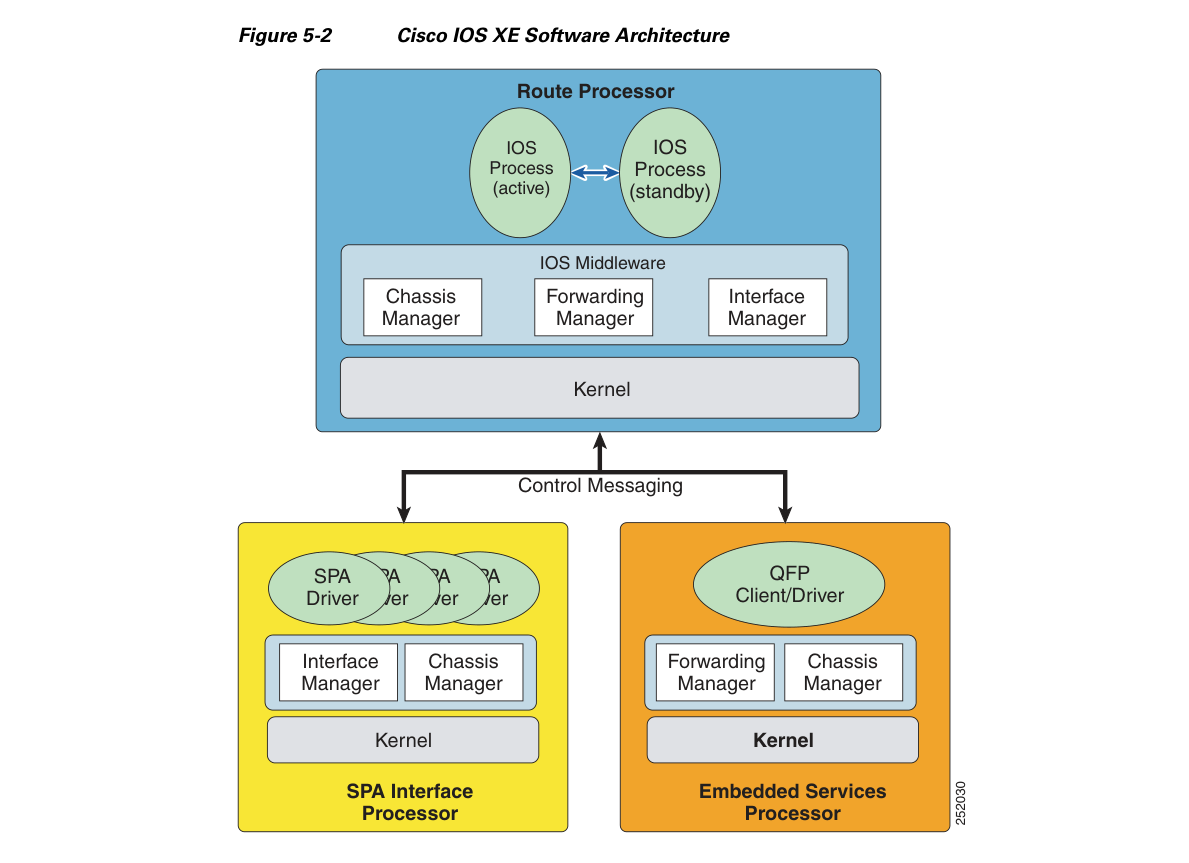
همان راهنما، Figure 5-2: IOS روی هسته لینوکس RP، و QFP Client روی Embedded Services Processor
در شکل رسمی، هر دو بلوک RP و هر دو ESP با برچسب active کشیده شدهاند. متن همان راهنما صریحتر است: یک RP و یک ESP فعالاند و جفت آماده را sync میکنند. برچسب شکل را با وضعیت زمان اجرا یکی نگیرید.
در همان راهنما، IOS روی RP مثل یک ماشین مجازی زیر هسته لینوکس است و به سختافزار مستقیم دست نمیزند. برای سیستم با یک پروسه IOS، حدود ۴۵ درصد حافظه RP یکبار به IOS داده میشود؛ اگر IOS افزونه (active/standby) داشته باشید، سهم هر کدام حدود ۲۰ درصد است. این عدد مال راهنمای عملیات ASR 1000 است، نه یک قانون برای 9300.
نتیجه عملی: موقع حادثه روی ASR دو نمودار جدا بکشید. اگر QFP پر است، کاربر کندی عبور میبیند. اگر CPU روتر RP پر است، ممکن است BGP کند شود در حالی که جریانهای از قبل برقرار هنوز از ESP رد میشوند. جابهجایی به ESP آماده، حالت فوروارد را با خود میبرد؛ به همین دلیل standby باید sync باشد. این را با 2960 مقایسه نکنید. آنجا یک CPU است و «گراف جدا» وجود ندارد.
NX-OS: سوپروایزر را ارزان فرض نکنید
روی نکسوس، سوپروایزر هم کنترلپلین را دارد هم منیجمنتپلین را. دیتاپلین روی موتور فوروارد است. راهنمای NX-OS صریح میگوید اختلال سوپروایزر یعنی قطعی جدی: از دست رفتن keepalive و update مسیریابی، flap مسیر، کند شدن CLI، و پر شدن صفها. مثال حملهای که خود سند میزند ICMP echo، IP fragment و TCP SYN flood است. لازم نیست حمله باشد. یک اسکن آسیبپذیری از داخل دیتاسنتر، یا یک SNMP walk سنگین، همان الگو را میسازد.
از اولین بوت، اگر setup را رد کنید یا گزینهای انتخاب نکنید، سیاست copp-system-p-policy-strict نصب میشود. چهار سطح در setup هست بهعلاوه skip که سیسکو توصیهاش نمیکند:
| پروفایل | رفتار، به زبان خود راهنمای 10.6 |
|---|---|
| strict | پیشفرض. یک نرخ و دو رنگ. از این شروع کنید |
| moderate | burst کلاس important بزرگتر از strict و کوچکتر از lenient |
| lenient | burst کلاس important بزرگتر از moderate و کوچکتر از dense |
| dense | CIR پایینتر از strict؛ سختگیرتر روی نرخ |
| skip | هیچ policy کنترلپلینی اعمال نمیشود. سند میگوید شبکه را در معرض آسیب میگذارد |
یک استثنای عملیاتی: با POAP، strict خودش اعمال نمیشود و باید CoPP را خودتان بگذارید. ارتقای NX-OS هم کلاسهای جدید پروتکل را خودبهخود به policy قدیمی شما تزریق نمیکند؛ یا setup یا copp profile لازم است. policy پیشفرض با upgrade عوض نمیشود. این را موقع برنامهریزی ارتقای نکسوس در پنجره شبانه یادتان باشد، وگرنه پروتکل تازهای که IOS منتظر محافظتش بوده بدون کلاس میماند.
show copp status
show policy-map interface control-plane
show copp profile strict
copp profile moderate
copp profile را وسط تولید، بدون خواندن drop counter، عوض نکنید. اول ببینید کدام کلاس drop دارد. اگر کلاس BGP drop میدهد و همسایه فلپ میکند، مشکل «کمبود پهنای باند اینترفیس» نیست.
IOS XR: FIB روی لاینکارت، MPP روی در مدیریت
در IOS XR، RIB بهترین مسیر را انتخاب میکند و آن را برای ساخت FIB به لاینکارت میفرستد. راهنمای سری 8000 میگوید خود پروسه RIB جدول FIB را نمیسازد؛ مسیرهای برگزیده را از راه Bulk Content Downloader به پروسه FIB هر لاینکارت میدهد و FIB آنجا ساخته میشود. پس کنترلپلین روی RP تصمیم میگیرد و دیتاپلین روی لاینکارت اجرا میکند. اگر یک لاینکارت FIB کهنه داشته باشد و بقیه تازه، سیاهچاله را فقط روی پورتهای همان کارت میبینید. این علامت را با «OSPF کلاً down است» عوضی نگیرید.
بسته به سمت خود روتر، قبل از اینکه CPU را غرق کند، از LPTS (Local Packet Transport Services) رد میشود. LPTS در عمل CoPP دنیای XR است: برای هر جریان کنترلی یک سقف محلی دارد. نقطه شروع دیدن policerها:
show lpts pifib hardware police location 0/RP0/CPU0محل دقیق location را از show platform همان شاسی بردارید. RP و لاینکارت اینترفیس ورودی یکی نیستند.
MPP لایه بعدی است و فقط در مدیریت را محدود میکند. نمونه، مطابق گامهای راهنمای ASR 9000، برای اینکه SSH فقط از یک اینترفیس و فقط از یک محدوده منبع پذیرفته شود:
configure
control-plane
 management-plane
  inband
   interface GigabitEthernet0/0/0/0
    allow SSH peer
     address ipv4 192.0.2.0/24
commit
show mgmt-plane inband
پورت اترنت خود RP بهصورت پیشفرض out-of-band حساب میشود و میشود زیر MPP گذاشتش. اگر MPP را روشن کنید و اینترفیس in-band کاربران را در فهرست نیاورید، SSH از همان VLAN دیتا دیگر داخل نمیشود. این رفتار درست است؛ غافلگیرکننده هم هست اگر نیمه شب از خانه به آدرس in-band وصل میشوید. قبل از commit، یک جلسه روی پورت out-of-band باز نگه دارید.
XR یک تفاوت عملیاتی دیگر هم دارد که مال پلین مدیریت است نه مال فوروارد: کانفیگ با commit وارد میشود و پروسهها از هم جدا هستند. خراب شدن یک پروتکل، کل IOS را با خودش نمیبرد آنطور که روی IOS یکپارچه قدیمی ممکن بود. این جداسازی همان دلیلی است که برای اینترنت و لبه اپراتور XR را برمیدارند، نه بهخاطر اینکه «دستورهایش قشنگتر است».
فایروال و وایرلس؛ کلمهها را قاطی نکنید
روی ASA و FTD دو مسیر آشنا داریم. Through-the-box دیتاپلین فایروال است: بستهای که از یک اینترفیس وارد میشود و از اینترفیس دیگر باید خارج شود، با قاعده دسترسی، NAT و inspection. To-the-box بستهای است که مقصدش خود فایروال است: SSH مدیریتی، BGP اگر روی ASA باشد، ترافیک failover. ACL معمولی اینترفیس، to-the-box را آنطور که انتظار دارید فیلتر نمیکند. برای آن، ACL را با کلمه control-plane به اینترفیس میچسبانند:
access-list CP-IN extended permit tcp 192.0.2.0 255.255.255.0 interface outside eq ssh
access-group CP-IN in interface outside control-plane
اگر این تفاوت را ندانید، ACL را روی outside سخت میکنید و فکر میکنید مدیریت بسته شده، در حالی که SSH به خود ASA هنوز از جای دیگری جواب میدهد. یا برعکس، یک permit اضافه برای تست میگذارید و در مدیریت را روی اینترنت باز میگذارید.
در وایرلس یک جفت کلمه دیگر هست که نباید با پلین جعبه عوض شود. بین AP و WLC، CAPWAP control روی UDP 5246 است و CAPWAP data روی UDP 5247. آن شکاف، مال تونل اکسسپوینت است. خود WLC یا سوئیچی که eWLC دارد باز هم CPU و ASIC خودش را دارد، و همان صفهای ۹ و ۱۰ روی Catalyst 9000 دقیقاً همین دو پورت را به CPU میبرند. FlexConnect هم داستان سوم است: فوروارد محلی AP یعنی دیتاپلین کاربر دیگر تا WLC نمیآید، ولی کنترلپلین AP همچنان به WLC وابسته است. اگر این سه لایه را یکی بگویید، موقع قطعی یا AP را ریبوت میکنید یا سوئیچ را، و هیچکدام علت نیست.
نمونه کانفیگ، هر کدام فقط روی پلتفرم خودش
بدترین عادت این موضوع، کپی کردن یک CoPP از وبلاگ IOS 12.4 روی Catalyst 9300 است. 9300 آن policy را قبول نمیکند، یا اگر جایی قبول کند رفتار سیستم را خراب میکند. نمونهها را جدا نگه دارید.
IOS و IOS XE کلاسیک، جایی که policy دست خودتان است
روی روتری که control-plane را با MQC آزاد میگذارد (نسل ISR قدیمی و برخی IOS XEها، نه سوئیچ 9000)، شکل کار این است. اعداد آزمایشگاهیاند؛ قبل از تولید، نرخ را با show policy-map control-plane و تایمر واقعی OSPF میزان کنید.
ip access-list extended COPP-ICMP
 permit icmp any any echo
ip access-list extended COPP-OSPF
 permit ospf any any
class-map match-all CM-ICMP
 match access-group name COPP-ICMP
class-map match-all CM-OSPF
 match access-group name COPP-OSPF
policy-map COPP-IN
 class CM-OSPF
  police rate 100 pps conform-action transmit exceed-action transmit
 class CM-ICMP
  police rate 50 pps conform-action transmit exceed-action drop
 class class-default
  police rate 200 pps conform-action transmit exceed-action drop
control-plane
 service-policy input COPP-IN
کلاس OSPF در این نمونه حتی در صورت عبور از نرخ، transmit میماند تا آزمایش را خراب نکنید. در تولید برای ICMP به سمت خود روتر drop معنی دارد؛ برای hello معمولاً نه، مگر نرخ را با حاشیه زیاد بالاتر از ترافیک سالم پروتکل گذاشته باشید. جهت را هم فراموش نکنید: این policy ورودیِ مسیر punt است.
Catalyst 9000: سیاست سیستمی را عوض نکنید، نرخ را اگر لازم شد دست بزنید
policy را خودتان service-policy نکنید. اگر بعد از خواندن drop counter واقعاً باید نرخ یک کلاس سیستمی را جابهجا کنید، شکل مجاز در راهنمای همین خانواده، police rate … pps زیر همان کلاس داخل system-cpp-policy است. و فردایش خروجی را با مقدار قبلی مقایسه کنید. اگر نمیدانید مقدار قبلی چه بوده، دست نزنید؛ show policy-map system-cpp-policy را ذخیره کنید.
بستن redirect، که اغلب از CoPP مؤثرتر است
interface Vlan10
 ip address 10.10.10.1 255.255.255.0
 no ip redirects
 no ip unreachables
no ip unreachables را کورکورانه روی هر جا نگذارید. بعضی عیبیابیها به unreachable وابستهاند. روی SVI کاربران که مرتب میزبان بیمسیر دارد، خاموش کردنش CPU را از ساختن ICMP نجات میدهد. روی لبه اینترنت، قبلاً اثرش را روی PMTU بفهمید.
مدیریت را از VLAN کاربران جدا کنید
interface GigabitEthernet0/0
 vrf forwarding Mgmt-vrf
 ip address 192.0.2.10 255.255.255.0
no ip http server
no ip http secure-server
line vty 0 4
 transport input ssh
 access-class 10 in
روی خیلی از Catalyst 9000ها پورت مدیریت از قبل در VRF به نام Mgmt-vrf است. SSH به آن آدرس، از طوفان VLAN کاربران جداست به شرطی که کابلش به همان سوئیچ access کاربران نرفته باشد. access-class جایگزین CoPP نیست؛ فقط منبع مجاز را کوچک میکند. هر دو را با هم بخواهید.
عیبیابی: اول بگویید کدام پلین بیمار است
یک ترتیب که در رک وقت را تلف نمیکند:
- یک پینگ transit واقعی بزنید، از میزبان پشت دستگاه به مقصدی که خود دستگاه نیست. اگر این سالم است و فقط پینگ به خود جعبه میپرد، دیتاپلین هنوز ایستاده و CPU یا CoPP درگیرند.
- CPU را با دستور مناسب همان پلتفرم بخوانید. روی 9000 هر دو عدد IOSd و control-processor را. روی ASR، QFP را جدا.
- علت punt را بشمارید، نه اینکه فقط درصد CPU را نگاه کنید.
punt cause summaryروی 9000 میگوید ARP است یا for-us یا L2 control. - drop مربوط به policer را بخوانید. drop در کلاس L2 همزمان با حلقه STP یک تشخیص است. drop در کلاس forus همزمان با مانیتورینگ یک تشخیص دیگر.
- اگر فقط CLI کند است و فوروارد سالم، جلسه را ببرید روی out-of-band و بعد در in-band را محدود کنید. وسط طوفان از روی همان VLAN کاربران
debug allنزنید. debug خودش کنترلپلین را میخورد.
| علامت | احتمال نزدیک | کجا را ببینید |
|---|---|---|
| کاربر عبور میکند، پینگ به SVI loss دارد | for-us دارد policed میشود یا CPU پر است | کلاس forus، علت For-us data |
| عبور هم خراب است، MAC flapping هست | حلقه لایه دو؛ BPDU به CPU نمیرسد یا دیر میرسد | صف L2 control، کابل اضافه، BPDU filter بیجا |
| OSPF فلپ، اینترفیس از نظر لایه یک سالم | drop کلاس routing، یا MTU، یا CPU | CoPP routing، show ip ospf traffic |
| فقط ساعت SNMP کند است | NMS دارد همان صف مدیریت را پر میکند | فرکانس polling، VRF مدیریت |
| ASR: کنسول سالم، عبور صفر | ESP / QFP | utilization دیتاپلین، وضعیت ESP فعال |
| XR: فقط پورتهای یک کارت سیاهچالهاند | FIB آن لاینکارت عقب مانده | مقایسه CEF همان location با RP |
| بعد از فعال کردن log روی ACL، CPU روتر قدیمی پر شد | هر hit به CPU punt میشود | ACL را از log خلوت کنید؛ CEF را چک کنید |
دستور خطرناک را هم بگوییم تا کسی از روی این صفحه برنداردش. debug ip packet و debug all روی دستگاه تولید یعنی خودتان مسیر punt را سیل کنید. اگر لازم است یک بسته را ببینید، روی 9000 از EPC استفاده کنید که در همان سند سیسکو بهعنوان علت punt هم دیده میشود؛ یعنی capture هم رایگان نیست و سهمی از CPU میگیرد. بازه و بافر را کوچک بگیرید و تمام که شد خاموش کنید.
آنچه در رک ایرانی همین شکاف را لو میدهد
شبکهای که هم 3750 دارد هم 9300، هم ISR قدیمی شعبه هم یک نکسوس در مرکز، سه نسل از این معماری را همزمان زنده نگه داشته. سیاستی که روی 9300 پیشفرض است روی 3750 وجود ندارد. پس در طوفان، جعبه قدیمیتر اول بیصدا میمیرد و جعبه جدیدتر فقط drop counter بالا میآورد و ظاهراً «سالم» است. گزارش کاربر برعکس این است: «سوئیچ جدید مشکل دارد» چون همان سالن را پوشش میدهد، در حالی که ریشه یک کابل برگشتی روی 3750 ته رک است.
مانیتورینگ را هم جدی بگیرید. سرور Zabbix یا PRTG که هر ده ثانیه SNMP اگرینترفیسهای یک 2960 را میخواند، برای آن CPU عدد کوچکی نیست. اگر آدرس مدیریت همان VLAN کاربران باشد، روزی که یک کارت شبکه خراب broadcast کند هم مانیتورینگ را از دست میدهید هم SSH را. پورت management سوئیچهای جدید را به یک VLAN یا سوئیچ جدا ببرید، حتی اگر آن سوئیچ جدا یک 2960 قدیمی فقط برای مدیریت باشد. طنزش را میفهمیم؛ ولی همان 2960 اگر فقط ترافیک مدیریت ببیند زنده میماند.
روی روتر شعبه که NAT و zone-based firewall و تونل همزمان دارد، بخشی از بستهای که «باید سختافزار باشد» به فرآیند برمیگردد. آنجا قبل از خرید پهنای باند بیشتر، show processes cpu و اگر IOS XE است نمودار QFP را ببینید. خیلی از شکایتهای «اینترنت شعبه کند است» سقف دیتاپلین همان ISR است، نه صف OSPF. و خیلی از شکایتهای «روتر هنگ کرد» در واقع SSH است که از پشت همان NAT به خود روتر hairpin میشود و صف for-us را پر میکند.
دوشنبه صبح چه کار کنیم
- برای هر جعبه یک خط بنویسید: دیتاپلین کجاست، مدیریت از کدام آدرس است، out-of-band دارد یا نه. اگر مدیریت in-band روی VLAN کاربران است، همان اولین کار است نه خرید شاسی جدید.
- یک بار در حالت سالم،
show policy-map control-planeیا معادل NX-OS را ذخیره کنید. بدون خط پایه، drop فردا معنی ندارد. - روی 9000 به
system-cpp-policyدست نزنید تا وقتی یک کلاس مشخص drop پایدار دارد و علتش را از punt cause میدانید. - روی نکسوس اگر کسی skip را انتخاب کرده، برگردید به strict و بعد اگر پروتکل خودتان drop میشود نرخ همان کلاس را باز کنید، نه اینکه CoPP را بردارید.
- روی XR، MPP را وقتی روشن کنید که یک مسیر out-of-band واقعاً کار میکند.
commitرا با جلسه پشتیبان بزنید. - Redirect و ACL log را در فهرست بازبینی SVI کاربران بگذارید. این دو بیشتر از «حمله پیچیده» CPU را میخورند.
- سقف را به همکاران مانیتورینگ بگویید: حدود ۱۹ هزار pps به CPU روی Catalyst 9000، و خیلی کمتر روی سوئیچ access قدیمی. polling را با این عدد طراحی کنید نه با تعداد پورت.
اگر این سه پلین را جدا ببینید، نصف تیکتهای «سوئیچ کند است» همان روز بسته میشود: یا عبور کند است (دیتاپلین، صف اینترفیس، فیبر، duplex)، یا خود جعبه کند است (punt و CoPP)، یا فقط ابزار شما کند است (منیجمنت). قاطی کردنشان یعنی ریبوت بیدلیل، و ریبوت یعنی پاک شدن همان شمارندهای که علت را میگفت.
پرسشهای کوتاه
تفاوت control plane و data plane در یک جمله؟
دیتاپلین بسته transit را از پورت به پورت میبرد. کنترلپلین بستهای را که مال خود دستگاه است، مثل OSPF و STP، پردازش میکند و جدول فوروارد را میسازد.
management plane جدا از control plane است؟
در تعریف NX-OS و IOS XR بله: SSH و SNMP مدیریتاند، BGP کنترل است. روی Catalyst 9000 هر دو از مسیر punt به CPU میرسند و سند سیسکو هر دو را زیر اسم عام control plane میآورد. جداسازی واقعیشان با پورت و VRF مدیریت است، نه با یک تراشه جادویی روی همه مدلها.
CEF همان data plane است؟
CEF روش ساختن و استفاده از جدول فوروارد است: FIB بهعلاوه adjacency. روی سوئیچ مدرن این جدول داخل ASIC برنامه میشود و آن ASIC دیتاپلین است. روی روتر CPU-محور قدیمی، CEF هنوز روی پردازنده اجرا میشود، فقط سریعتر از process switching.
چرا پینگ به خود سوئیچ loss دارد ولی کاربران آنلایناند؟
پینگ به SVI مال for-us است و از لوله CPU رد میشود. ترافیک کاربران transit است و از ASIC رد میشود. پس loss روی پینگ خود سوئیچ، تا وقتی حلقه لایه دو یا خود ASIC خراب نشده، یعنی دیتاپلین هنوز سر جایش است و لوله CPU یا CoPP پر شده.
CoPP را روی 9300 خودم بنویسم؟
خیر. فقط system-cpp-policy روی control-plane مجاز است. کار شما دیدن drop و، اگر لازم شد، دست زدن به نرخ یک کلاس با واحد pps است؛ نه چسباندن policy-map یک روتر ISR قدیمی.
منابع رسمی
- Troubleshoot Control Plane Operations on Catalyst 9000 Switches؛ سقف حدود ۱۹٬۰۰۰ pps، FED و IOSd، صفها و دستورهای punt
- Catalyst 9300, IOS XE 16.6 — Configuring Control Plane Policing
- Nexus 9000 NX-OS 10.6 — Configure Control Plane Policing
- IOS XE QoS — Control Plane Policing و اینترفیس punt/inject
- IOS 15M&T — Control Plane Protection، زیررابط host و transit و CEF-exception
- Understand Express Forwarding (CEF)
- ASR 1000 Operations — Monitoring the Control Plane؛ RP، ESP، EOBC و ESI
- ASR 9000 IOS XR — Implementing Management Plane Protection
- IOS XR 8000 — RIB و دانلود مسیر به FIB لاینکارت
مشاوره و پیادهسازی با آکانت
آکانت (Akanet) با بیش از بیست سال سابقه در شبکههای سیسکو، کنار سازمانهایی است که همزمان سوئیچ access قدیمی و شاسی جدید دارند و باید بدانند کندی مال ASIC است یا مال CPU. جدا کردن آدرس مدیریت، خواندن CoPP بدون کور کردن OSPF، و بستن مسیری که طوفان را به سوپروایزر میرساند کار همان رک است، نه جمعبندی یک اسلاید. اگر تیکت «سوئیچ کند است» هر ماه برمیگردد، از روی شمارنده punt میشود علت را جدا کرد.
وفقک الله